Wasn't Me!
Anonimiza un documento antes de que un modelo lo vea
wasntmesolo el dueñoen líneaQué es
Anonimiza un PDF o un Word antes de pasárselo a un modelo: detecta nombres, fechas, cuentas y demás con reglas por dominio y un modelo de reconocimiento de entidades, te deja revisar cada hallazgo y exporta un PDF sin los datos. Todo en tu navegador.
Para quién
Para quien tiene que pegar un documento con datos de terceros en un chat de IA y no quiere que salgan: historias clínicas, contratos, evaluaciones, extractos, informes de incidentes. Nació en el Build Night de Múnich.
Qué hace
- Cinco dominios (médico, contratos, RRHH, finanzas, TI) que cambian qué patrones se buscan.
- Revisión detección por detección, con el riesgo y la confianza como dos números distintos; pantalla pensada para teclado.
- Sustitución por marcadores numerados ([NAME_1]…) y exportación a PDF rasterizado: el texto original ya no está en el archivo.
- Verificación: el PDF resultante se vuelve a leer y se busca cada valor sustituido.
- Diez documentos de muestra, todos ficticios, para probar.
Qué gasta
El documento no sale de tu navegador: se lee, se escanea, se edita y se reexporta en tu equipo. Lo único que entra es el modelo de detección (135 MB la primera vez, luego en caché) y las fuentes.
Antes de pedirla
Los PDF escaneados sin capa de texto no se procesan (no hay OCR). El modelo pesa 135 MB: en un móvil con datos, mejor no.
Capturas
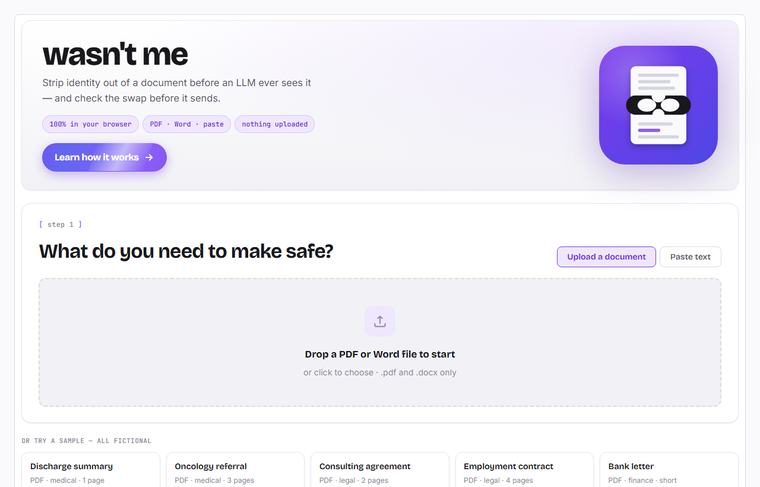
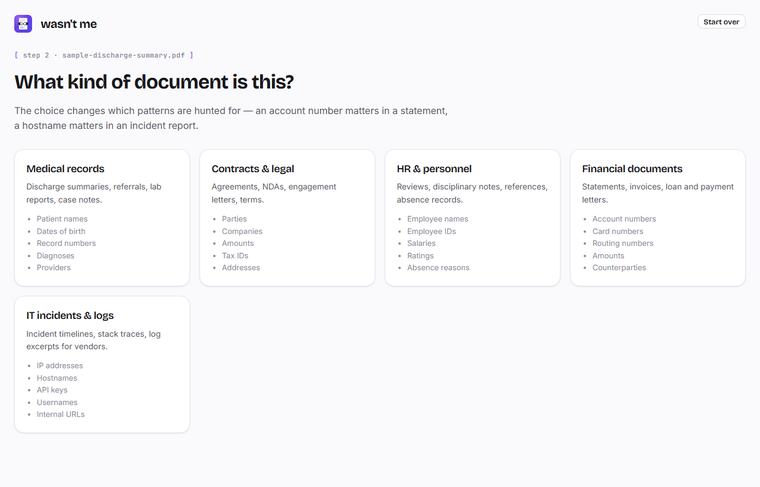
Capturas tomadas en local con datos de prueba.